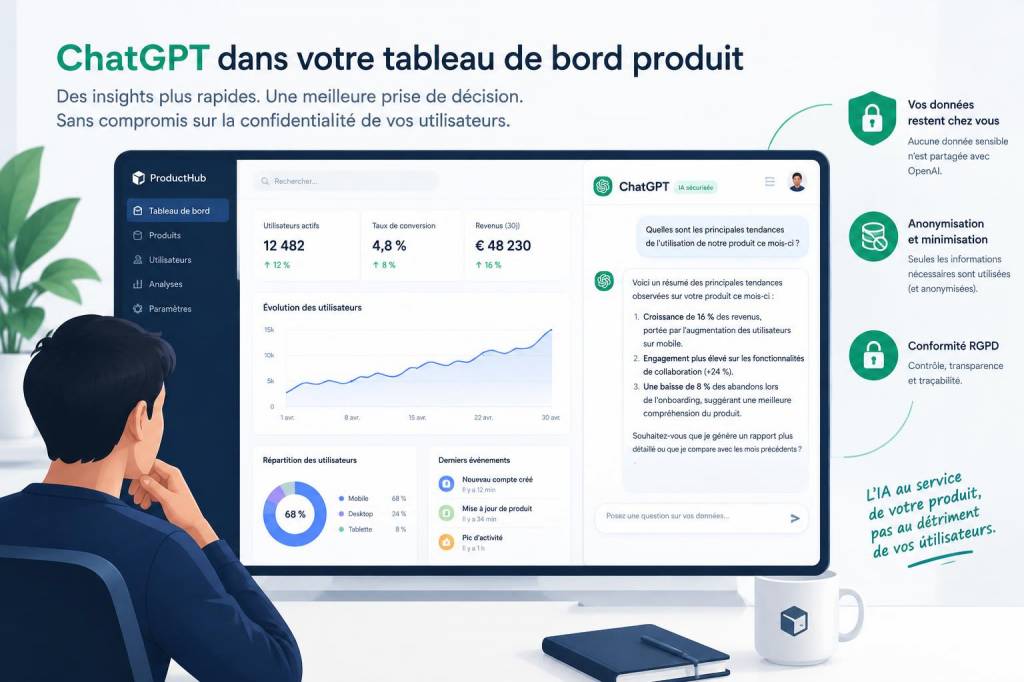
Quand j'ai commencé à intégrer des fonctionnalités basées sur ChatGPT dans des tableaux de bord produits, j'avais deux priorités contradictoires : offrir une aide contextuelle puissante et préserver la confidentialité des utilisateurs. Rapidement j'ai compris que la valeur perçue d'un assistant IA peut s'effondrer si les utilisateurs craignent que leurs données sensibles soient exposées. Voici donc une synthèse pratique et personnelle des stratégies que j'ai testées pour concilier ces exigences — techniques, organisationnelles et UX — afin d'intégrer ChatGPT sans sacrifier la vie privée.
Commencer par les questions fondamentales
Avant d'implémenter quoi que ce soit, je me pose toujours les questions suivantes :
Quelles données nécessaires pour que l'IA apporte une vraie valeur ?Peut-on anonymiser ou minimiser ces données sans perte de qualité ?Quelle est la surface d'exposition : API externe, logs internes, stockage d'embeddings ?Quel niveau de conformité (GDPR, CCPA, sectoriel) doit-on respecter ?Répondre à ces questions détermine ensuite le choix d'architecture et les garde-fous à mettre en place.
Architecture recommandée : séparation des responsabilités
J'utilise habituellement une architecture en couches :
Proxy serveur : une couche backend intermédiaire entre le produit et l'API LLM (ex. OpenAI, Azure OpenAI, Anthropic). Le proxy applique des contrôles (filtrage, anonymisation, quotas) et évite que les clés API soient exposées côté client.Sanitisation et redaction : avant d'envoyer du texte au LLM, on supprime ou anonymise les PII (noms, emails, numéros, tokens sensibles).Embeddings & RAG privées : pour contextualiser les réponses, j'utilise des embeddings stockés dans une base chiffrée (Chroma, Milvus, Pinecone avec encryption) et un pipeline RAG qui ne transfère au LLM que les snippets pertinents et nettoyés.Logging contrôlé : logs minimaux et masqués, avec conservation limitée et accès restreint.Techniques de minimisation des données
Voici les pratiques concrètes que j'applique systématiquement :
Ne pas envoyer l'intégralité du contexte : on tronque les historiques de conversation et on n'inclut que les éléments utiles (extraits pertinents via scoring).Tokenisation & redaction automatique : j'exécute des algorithmes de détection PII (regex, modèles NER légers) pour masquer noms, emails, cartes de crédit. Par exemple, remplacer "[email protected]" par "[EMAIL_REMOVED]".Résumé local : au lieu d'envoyer des logs bruts, je fais résumer côté serveur (ou par un LLM interne) puis j'envoie uniquement le résumé anonyme au LLM externe.Désidentification : pour certains cas, je pseudo-anonymise les identifiants (hashing salé) afin de garder la possibilité de corrélation sans exposer l'identité.Choix du modèle : cloud vs local
Le choix du modèle a un impact lourd sur la confidentialité :
| Cloud API (OpenAI, Anthropic, Azure) | Rapide à intégrer, haute qualité des réponses, mais les données transitent vers un fournisseur externe. Vérifier les clauses de non-rétention et les options d'entreprise (contracts, Azure Private Link). |
| Modèles hébergés en privé (Llama 2, Mistral, etc.) | Meilleur contrôle des données, déploiement on-premise ou sur VPC, mais exige plus d'infra et d'optimisation. |
| Inference hybride | On exécute des tâches sensibles sur un modèle local et on délègue les requêtes générales à une API cloud. Utile pour équilibrer coût et confidentialité. |
RAG (Retrieval-Augmented Generation) — comment le rendre privé
Le RAG est puissant pour fournir des réponses contextuelles. Mes règles d'or :
Stocker les embeddings chiffrés au repos et limiter les droits d'accès.Ne pas inclure de PII dans les chunks indexés, ou appliquer une redaction préalable.Limiter la quantité de contexte concaténé au prompt (ex. 2-3 passages les plus pertinents).Surveiller les "prompt injection" : un passage dans le contenu ne doit pas modifier les instructions système. J'isole le contenu utilisateur et utilise des instructions système strictes.Logging, audits et retention
Les logs sont souvent la faille oubliée. J'ai adopté ces règles :
Stocker uniquement les métadonnées indispensables (latence, statut) et anonymiser les requêtes si elles doivent être conservées.Activer le chiffrement en transit (TLS) et au repos (AES-256 ou équivalent).Définir une politique de conservation (par ex. suppression automatique au bout de 30 jours pour les logs de requêtes) et la documenter.Auditer périodiquement les accès et utiliser l'authentification forte (MFA, IAM strict).UX et transparence pour les utilisateurs
La confidentialité, c'est aussi une promesse perçue. J'intègre toujours :
Un bandeau/infobulle expliquant quelles données sont envoyées au service IA et pourquoi.Un contrôle utilisateur pour désactiver l'IA pour certains types de données ou sessions.Une option "mode local" ou "ne pas envoyer" pour les utilisateurs très sensibles.Des messages clairs en cas d'erreur (ex. si la requête a été refusée pour des raisons de sécurité).Considérations légales et contractuelles
Ne négligez pas le juridique. Je vérifie systématiquement :
Les clauses de traitement des données chez le fournisseur de LLM (retention, réutilisation, sous-traitance).La possibilité de signer des Data Processing Agreements (DPA) et d'utiliser des options de contrat entreprise.Les obligations de notification en cas de brèche et les mesures de mitigation requises par la réglementation applicable.Checklist opérationnelle rapide
Mettre en place un proxy backend pour centraliser les contrôles.Appliquer redaction et détection PII avant toute requête.Stocker embeddings et contextes chiffrés, restreindre les accès.Limiter la longueur du contexte envoyé au modèle et privilégier le résumé.Choisir entre cloud vs modèle privé selon le niveau de sensibilité.Documenter la politique de logs et la conserver le moins longtemps possible.Informer les utilisateurs et offrir des options de contrôle.Signer DPA et vérifier conformité fournisseur.Intégrer ChatGPT dans un tableau de bord produit n'est pas seulement une question technique : c'est un mélange d'architecture, d'UX, de sécurité et de confiance. En appliquant ces principes j'ai pu déployer des assistants utiles tout en gardant la maîtrise des données sensibles de mes utilisateurs. Si vous voulez, je peux partager un exemple d'architecture détaillé (diagramme de flux) ou un snippet de proxy pour illustrer l'implémentation concrète.